Amazonbot : quand le robot d'Amazon met votre serveur à genoux
Sur les serveurs que nous administrons, Amazonbot revient régulièrement dans nos analyses de trafic, aux côtés d'autres robots d'IA comme GPTBot ou meta-externalagent. Ce n'est pas une position de principe contre l'IA : nous l'avons observé lors de plusieurs épisodes de charge où le robot d'Amazon arrivait en tête des journaux, sur des sites qui ne lui ont jamais rien rapporté.
Cet article raconte ce que fait Amazonbot, pourquoi il pèse si lourd sur des boutiques en ligne, comment le repérer dans vos logs et quelles options s'offrent à vous pour le calmer ou le bloquer.
Amazonbot, c'est quoi exactement ?
Amazonbot est le robot d'exploration généraliste d'Amazon : selon sa page officielle, il sert à améliorer les produits et services de l'entreprise et peut être utilisé pour entraîner ses modèles d'IA. Historiquement présenté comme le robot qui nourrit Alexa, il est aujourd'hui clairement un collecteur de données d'entraînement.
Amazon distingue désormais trois agents, chacun réglable séparément dans le robots.txt :
| Agent | Rôle déclaré | Entraînement IA | Respect du robots.txt |
|---|---|---|---|
| Amazonbot | Amélioration des produits et services | Oui, possible | Oui |
| Amzn-SearchBot | Expériences de recherche (Alexa, etc.) | Non | Oui ; à défaut de règle dédiée, suit celles données aux autres moteurs |
| Amzn-User | Récupération en direct pour répondre à un utilisateur | Non | Pas toujours, car l'action est déclenchée par un humain |
Le user-agent ressemble à un Chrome ordinaire suivi de la mention compatible; Amazonbot/0.1. Amazon publie la liste des IP de chaque agent, ce qui permet de distinguer le vrai robot d'un imposteur.
Un détail compte beaucoup pour un hébergeur : Amazonbot ne prend pas en charge la directive Crawl-delay. Impossible, donc, de lui demander simplement de ralentir. Il respecte en revanche Disallow, rel=nofollow et les balises meta noindex et noarchive, cette dernière signifiant chez Amazon « ne pas utiliser la page pour l'entraînement ». Toute modification du robots.txt peut mettre environ 24 heures à être prise en compte, et le robot peut se fier à une copie en cache vieille de 30 jours.
Les problèmes observés
Le reproche principal fait à Amazonbot n'est pas d'exister, mais d'arriver par vagues, sans prévenir et sans frein. Nous ne sommes pas les seuls à l'avoir constaté.
| Qui | Quand | Ce qui s'est passé |
|---|---|---|
| Xe Iaso, développeuse | Janvier 2025 | Son serveur Git auto-hébergé devient instable sous le trafic attribué à Amazon ; elle finit par écrire Anubis, un filtre anti-robots par preuve de travail (Ars Technica) |
| git.gmem.ca | Juin 2024 | Environ 25 000 requêtes d'Amazonbot bloquées en moins de 24 heures sur une petite forge Git |
| Hypernode, hébergeur e-commerce | Mai 2023 | Plusieurs serveurs de boutiques en ligne dont plus de 10 % de la puissance de calcul partait dans Amazonbot ; trafic très variable d'une semaine à l'autre |
| Forum Discourse | 2021 | 39 649 requêtes d'Amazonbot contre 457 pour le visiteur suivant ; une dizaine d'IP AWS envoyant chacune plus de 1 000 requêtes dans la journée ; l'auteur soupçonne finalement un imposteur |
Ces cas ont un point commun : le robot s'attaque aux pages les plus coûteuses à produire. Sur une forge Git, ce sont l'historique des commits et les vues blame. Sur une boutique WooCommerce ou PrestaShop, ce sont les filtres à facettes : chaque combinaison de couleur, taille, prix et marque génère une URL distincte, donc un nombre de pages pratiquement infini.
Un robot qui suit tous les liens sans limite de rythme explore alors des milliers de combinaisons que personne ne consultera jamais. Chacune contourne le cache de page, puisque l'URL est unique, et déclenche une requête PHP et plusieurs requêtes SQL.
Un cas réel : Amazonbot piégé par la pagination JetBlog
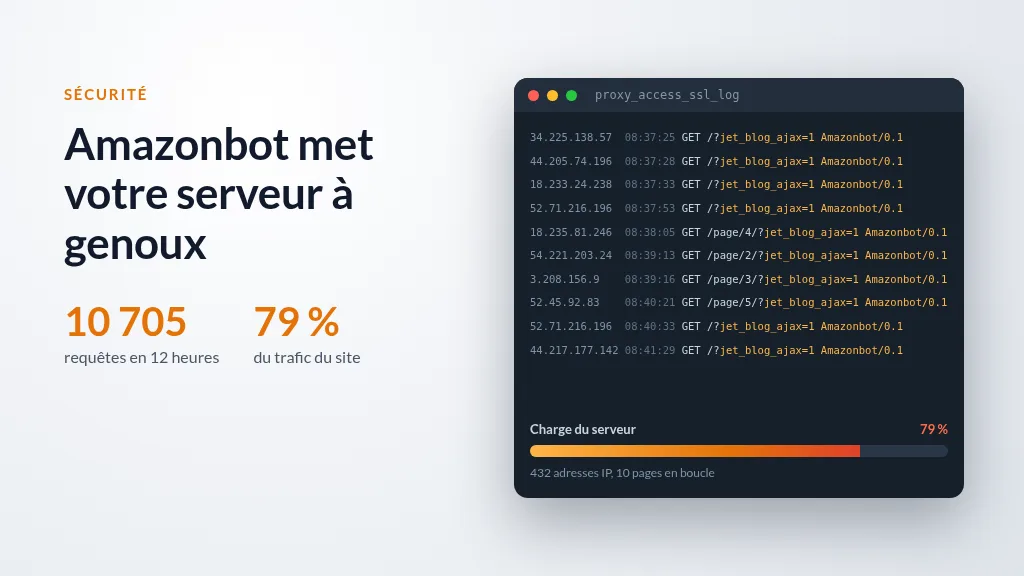
Début octobre 2026, sur un site WordPress de notre parc, Amazonbot a tourné en boucle sur la pagination d'un blog. Sur 12 heures le 5 octobre, il a envoyé 10 705 requêtes depuis 432 adresses IP, soit 79 % de tout le trafic du site. Le manège continuait le lendemain ; voici un extrait réduit du journal d'accès du 6 octobre (le site n'apparaît pas, le user-agent est abrégé) :
34.225.138.57  [06/Oct/2026:08:37:25] "GET /?jet_blog_ajax=1&nocache=1791224346&s"        200 32057 "-" "…Amazonbot/0.1…"
44.205.74.196  [06/Oct/2026:08:37:28] "GET /?jet_blog_ajax=1&nocache=1791228922&s"        200 32057 "-" "…Amazonbot/0.1…"
18.233.24.238  [06/Oct/2026:08:37:33] "GET /?jet_blog_ajax=1&nocache=1791120571&s"        200 32056 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:37:53] "GET /?jet_blog_ajax=1&nocache=1791224758&s"        200 32057 "-" "…Amazonbot/0.1…"
18.235.81.246  [06/Oct/2026:08:38:05] "GET /page/4/?jet_blog_ajax=1&nocache=1791241950&s" 200 31720 "-" "…Amazonbot/0.1…"
54.221.203.24  [06/Oct/2026:08:39:13] "GET /page/2/?jet_blog_ajax=1&nocache=1791241202&s" 200 31618 "-" "…Amazonbot/0.1…"
3.208.156.9    [06/Oct/2026:08:39:16] "GET /page/3/?jet_blog_ajax=1&nocache=1791240922&s" 200 31948 "-" "…Amazonbot/0.1…"
52.45.92.83    [06/Oct/2026:08:40:21] "GET /page/5/?jet_blog_ajax=1&nocache=1791241462&s" 200 30055 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:40:33] "GET /?jet_blog_ajax=1&nocache=1791213591&s"        200 32056 "-" "…Amazonbot/0.1…"
44.217.177.142 [06/Oct/2026:08:41:29] "GET /?jet_blog_ajax=1&nocache=1791126368&s" 200 32057 "-" "…Amazonbot/0.1…"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot) Chrome/119.0.6045.214 Safari/537.36| Mesure (5 octobre, de 08h à 20h) | Valeur |
|---|---|
| Requêtes Amazonbot | 10 705, soit une toutes les 4 secondes en moyenne |
| Part du trafic total du site | 79 % (10 705 requêtes sur 13 611) |
| Dont pagination JetBlog | 100 % |
| Régularité | Entre 887 et 896 requêtes chaque heure, 16 au plus sur une minute |
| Adresses IP distinctes | 432 ; la plus active n'a envoyé que 52 requêtes en 12 heures |
| Pages réellement différentes | 10 : l'accueil et les pages 2 à 5 du blog, la page Références et ses pages 2 à 4, une page de présentation |
| Réponses | 100 % en HTTP 200 |
| Volume servi | 323,6 Mo, soit environ 30 Ko par requête |
| Projection sur 24 heures à ce rythme | Environ 21 000 requêtes et 650 Mo |
| IP vérifiées dans la liste officielle Amazonbot | 58 sur 58 dans l'extrait du 6 octobre (liste du 8 septembre 2026) |
Ce que montre cet extrait
C'est bien Amazonbot, pas un imposteur. Toutes les IP de l'extrait figurent dans la liste publiée par Amazon. Le robot officiel d'une multinationale peut donc, à lui seul, produire ce type de trafic.
Le robot est tombé dans un piège à URL infinies. Le module de blog JetBlog (suite Crocoblock pour Elementor) charge sa pagination en AJAX. Ses liens portent jet_blog_ajax=1 et un paramètre nocache différent à chaque affichage. Pour un robot, chaque valeur est une page nouvelle : il redemande sans fin les dix mêmes pages sous des noms différents, à un rythme de métronome. Les valeurs de nocache ressemblent d'ailleurs à des horodatages des jours précédents, signe que le robot rejoue des liens collectés lors de passages antérieurs.
Le cache ne sert à rien. Chaque URL étant unique, aucune réponse n'est servie depuis le cache : les 10 705 requêtes des 12 heures ont été calculées par PHP et MySQL, pour renvoyer en boucle les mêmes dix pages.
Bloquer par IP est inutile. Avec 432 adresses en 12 heures, l'IP la plus active n'a envoyé que 52 requêtes, à peine plus de 4 par heure. Un fail2ban ou une limite de débit par IP ne voit rien d'anormal ; seule la signature de la requête, user-agent ou forme de l'URL, permet de réagir.
Ce que nous avons mis en place
Plutôt que de bloquer Amazonbot, nous avons traité la cause : une règle au niveau du pare-feu applicatif neutralise ce piège pour tous les robots. Une pagination JetBlog demandée sans l'en-tête AJAX X-Requested-With, ce qu'aucun navigateur ne fait, est redirigée en 301 vers l'URL propre. Le robot retombe alors sur une seule adresse, servie par le cache.
Pourquoi c'est si coûteux pour un hébergeur
Sur un serveur mutualisé, un robot qui s'emballe sur un site ralentit tous les autres. Les processus PHP, les connexions MySQL et la mémoire sont partagés : quelques milliers de pages de facettes générées en une heure suffisent à rallonger les temps de réponse de dizaines de sites qui n'ont rien demandé.
Trois facteurs aggravent le cas d'Amazonbot :
- Pas de
Crawl-delay. Le seul réglage standard pour demander de ralentir est ignoré. Il ne reste que l'interdiction pure et simple, partielle ou totale. - Des pages dynamiques uniquement. Un robot d'exploration ne télécharge ni images, ni CSS, ni JavaScript ; il ne demande que du HTML, c'est-à-dire la partie la plus chère à produire.
- Aucun retour. Contrairement à Googlebot ou Bingbot, Amazonbot n'apporte aucun visiteur mesurable à une boutique française. Le coût serveur est réel, le bénéfice reste hypothétique.
C'est ce déséquilibre, plus que le volume brut, qui justifie de le traiter à part des moteurs de recherche classiques.
Le repérer dans ses logs
Amazonbot se signale honnêtement par son user-agent : une simple recherche du mot Amazonbot dans les journaux d'accès suffit pour une première mesure. Sur un serveur Plesk, les logs sont dans /var/www/vhosts/system/<domaine>/logs/ ; si nginx sert de proxy devant Apache, lisez les fichiers proxy_access*.
Les sites les plus visités par Amazonbot :
for d in /var/www/vhosts/system/*/; do
  n=$(cat "$d"logs/*access_ssl_log 2>/dev/null | grep -c Amazonbot)
  [ "$n" -gt 0 ] && echo "$n $(basename "$d")"
done | sort -rn | head
Le rythme heure par heure sur un site, pour repérer les vagues :
grep Amazonbot /var/www/vhosts/system/site.fr/logs/proxy_access_ssl_log \
  | awk '{print substr($4, 2, 14) "h"}' | uniq -c | tail -24
Vrai robot ou imposteur ?
N'importe qui peut écrire « Amazonbot » dans un user-agent, et beaucoup de robots malveillants tournent sur des serveurs AWS loués, donc avec des IP appartenant à Amazon. Une IP « Amazon » ne prouve rien : le cas Discourse de 2021 venait d'IP EC2 et son auteur a conclu à un imposteur.
Deux vérifications fiables :
- Comparer l'IP à la liste publiée par Amazon.
- Faire une résolution DNS inverse : le vrai robot répond par un nom en
crawl.amazonbot.amazon, que l'on confirme ensuite par une résolution directe.
host <IP suspecte>          # doit renvoyer ...crawl.amazonbot.amazon
host <nom renvoyé>          # doit renvoyer la même IP
Cette distinction compte : un imposteur ignore le robots.txt, et seul un blocage côté serveur l'arrêtera.
Les parades, de la plus douce à la plus ferme
1. Le robots.txt, site par site
C'est la méthode courtoise, et Amazon s'engage à la respecter pour Amazonbot. Elle ne protège que du vrai robot et met jusqu'à 24 heures à s'appliquer.
Interdire tout le site :
User-agent: Amazonbot
Disallow: /
Ou seulement les facettes, en laissant les fiches produits accessibles :
User-agent: Amazonbot
Disallow: /*?*filter_
Disallow: /*?*pa_
Disallow: /*?*min_price=
Disallow: /*?*q=
Pour refuser l'usage de vos textes dans l'entraînement sans bloquer l'exploration, Amazon reconnaît aussi la balise <meta name="robots" content="noarchive">.
2. ModSecurity, au niveau du serveur
Le robots.txt ne vaut que pour les robots qui le respectent, et il se modifie site par site. Le pare-feu applicatif ModSecurity agit en amont : il refuse une requête selon son user-agent ou la forme de son URL avant que WordPress ou PrestaShop ne soit sollicité. Une requête bloquée à ce stade ne coûte presque rien au serveur, et les imposteurs qui se font passer pour Amazonbot sont arrêtés aussi.
Sur un serveur Plesk, ce réglage peut s'appliquer domaine par domaine, pour protéger un site précis sans toucher aux autres, ou de façon globale pour tous les sites hébergés. Le bon niveau dépend de vos sites et de leur trafic : c'est à voir avec notre équipe technique, qui vérifiera ensuite dans les journaux que le réglage produit l'effet attendu.
3. Attention à votre code : pas de trous noirs pour les robots
Le cas JetBlog le montre : le problème ne venait pas seulement du robot, mais d'un module qui fabriquait des URL à l'infini. Pour un robot d'exploration, chaque lien inédit est une page nouvelle à visiter. Un site qui en génère sans fin devient un trou noir qui l'aspire, et chaque passage se paie en ressources serveur.
Les sources de trous noirs les plus courantes :
- les paramètres anti-cache ou horodatés ajoutés aux liens, comme le
nocachede la pagination AJAX de JetBlog ; - les filtres à facettes WooCommerce ou PrestaShop, dont les combinaisons se comptent par milliers ;
- les calendriers et archives qui permettent d'avancer de mois en mois sans fin ;
- les pages de recherche interne accessibles par lien, y compris avec une recherche vide (
?s=).
Quelques réflexes suffisent souvent : regarder dans vos journaux quelles URL les robots visitent réellement, ne pas exposer en lien classique des adresses destinées au seul AJAX, marquer ces liens rel="nofollow", qu'Amazonbot respecte, et interdire leurs motifs dans le robots.txt :
User-agent: *
Disallow: /*jet_blog_ajax=
Disallow: /*?*filter_
Dans notre cas, puisqu'il s'agissait du vrai Amazonbot, la première de ces lignes aurait suffi à lui faire abandonner la pagination JetBlog, avec le délai d'environ 24 heures annoncé par Amazon.
Bloquer ou pas ?
Le blocage d'Amazonbot est sans effet sur le référencement Google ou Bing, ce qui en fait une décision à faible risque pour la plupart des sites. Il y a malgré tout des arguments des deux côtés.
| Bloquer | Laisser passer |
|---|---|
| Charge serveur réduite, surtout sur les boutiques à facettes | Visibilité possible dans les réponses d'Alexa et des services d'IA d'Amazon |
| Contenus non réutilisés pour entraîner des modèles | Programme Amazon Content Partners : petit bonus de commission d'affiliation et crédits d'hébergement pour les sites qui l'autorisent |
| Aucune perte de trafic mesurable pour un site français | Le blocage par user-agent n'arrête pas les imposteurs, qui exigent de toute façon d'autres défenses |
Pour un site affilié à Amazon ou un média qui vise la recherche vocale, un blocage partiel, limité aux facettes et aux pages de recherche, est un bon compromis. Pour une boutique hébergée sur un serveur partagé, le blocage complet reste le choix le plus simple.
En résumé
Amazonbot n'est pas un pirate : il s'annonce, publie ses IP et respecte le robots.txt. Mais il ne sait pas ralentir, il cible les pages les plus chères et n'apporte presque rien aux sites qu'il visite. Mesurez d'abord sa part dans vos logs, vérifiez qu'il s'agit bien de lui, puis choisissez entre un robots.txt ciblé et un blocage serveur. Et quel que soit votre choix, protégez vos facettes : le prochain robot ne sera peut-être pas aussi poli.
Chez HaiSoft, nous surveillons le trafic des sites que nous hébergeons et des serveurs que nous infogérons. Un robot pèse sur votre site ou vous hésitez sur la bonne parade ? Contactez notre équipe technique.
Sources
- Amazon Developer : About Amazonbot
- Amazon Developer : liste des IP d'Amazonbot
- Xe Iaso : Amazon's AI crawler is making my git server unstable
- Ars Technica, via Harvard TagTeam : Devs say AI crawlers dominate traffic
- Hypernode : How Amazon's web crawler could impact the performance of your online store
- Discourse Meta : Amazonbot abusive crawling
- SegmentFault : résumé du billet de git.gmem.ca